
本文介绍 Gitee 项目 liukeying011/mitedb。文章原文固定保存在 IoTPaper,源码与许可证仍以 Gitee 仓库 为准。本文核对的源码提交是 b46628cc214061228f76a696740545e5f2695d40;仓库后续变化不自动继承本文结论。
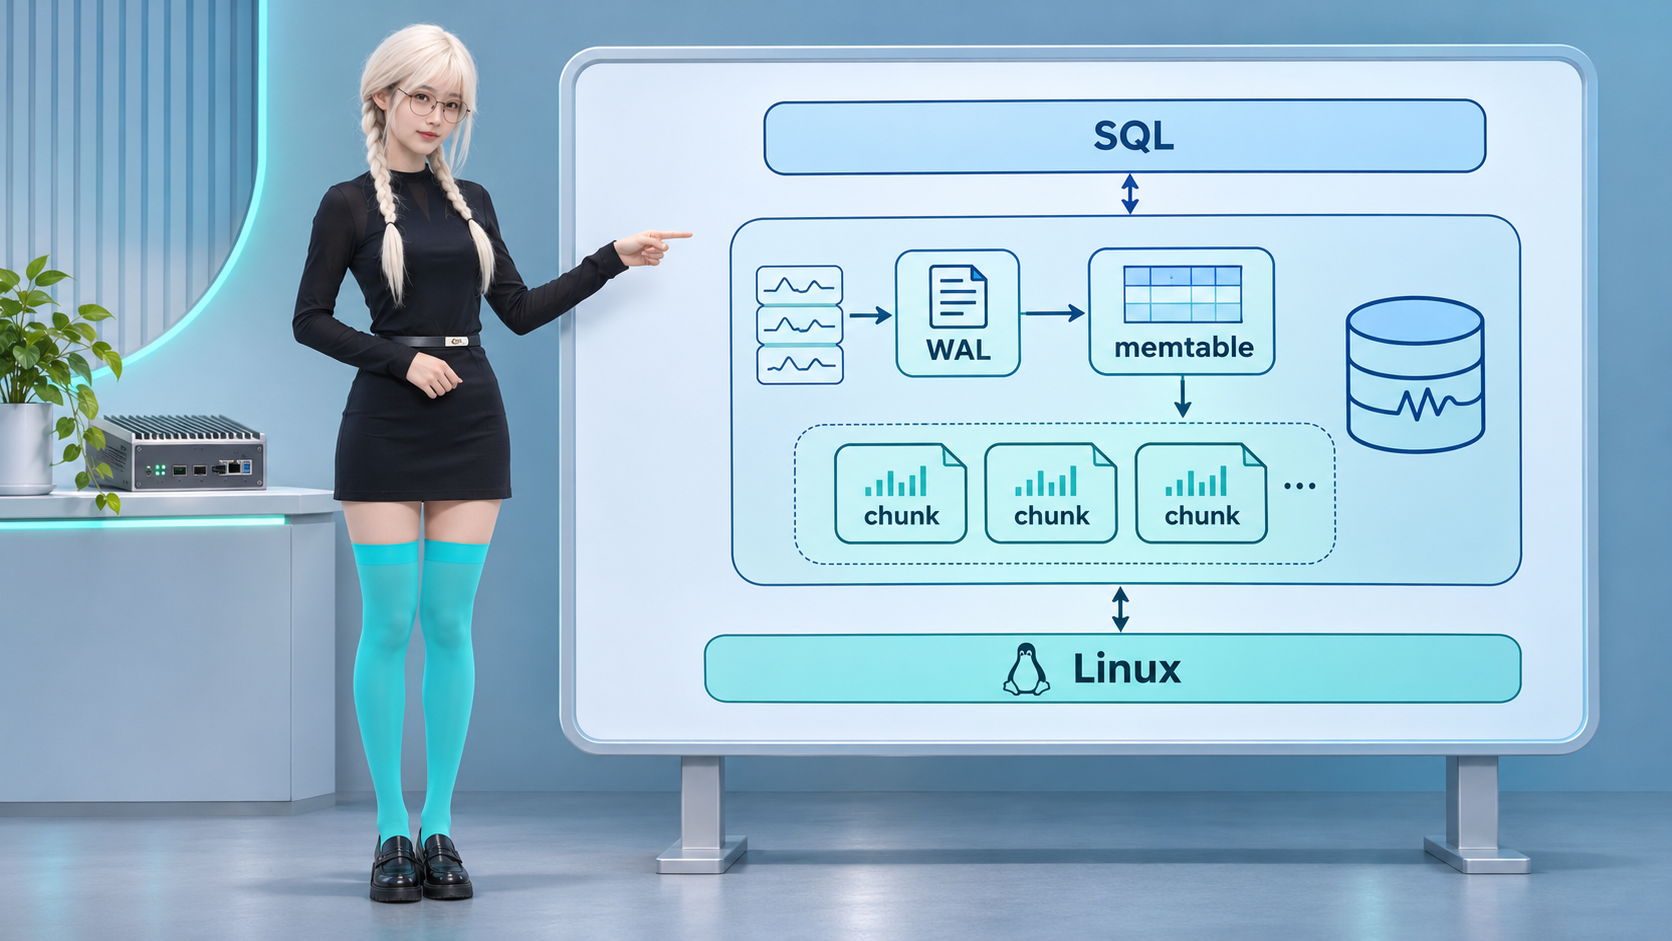
图1:同一位当前批准代言人配合 MiteDB 的 C API、WAL、列式 chunk 和查询路径示意。
为什么要把时序数据库放进进程
在网关、采集器或边缘计算盒子里,数据采集程序往往已经是常驻进程。再启动一个数据库服务,就要增加端口、配置文件、进程监控、升级和故障恢复的运维面。MiteDB 选择了 SQLite 相似的形态:应用链接 libmite,通过 C API 打开一个目录,数据留在本机,不需要独立服务,也不监听网络端口。
这个取舍适合“设备先把数据可靠地存下来”的场景。它可以承担传感器读数、设备状态和边缘统计的本地缓冲,再由上层应用决定何时上传、压缩或同步。它不是一个自带网络协议、集群选主和远程查询入口的服务型数据库,部署前应先把数据边界画在设备架构里。
存储路径:WAL、memtable 与列式 chunk
从源码和 README 可以看到,MiteDB 的写入路径由 Inserter 或事务进入 memtable,再追加到 WAL;满足容量或时间条件后 flush 为不可变的列式 chunk。chunk 使用 delta/Gorilla 等列编码,查询端通过索引剪枝和解码 LRU 减少无关列块读取。MANIFEST、列式 chunk 和 WAL 都位于数据库目录中,格式固定小端,便于在不同架构之间搬运文件。
写入接口提供批量 Inserter、Group Commit、多语句事务和乱序窗口;查询接口同时提供 SQL 子集、流式游标、聚合与预处理语句。超级表(STable)和标签谓词下推则面向多个点位共享 schema 的设备模型。mite_opts_t 允许限制 memtable、缓存、乱序窗口、保留期和后台线程数量,意味着设备可以把资源预算写进配置,而不是把内存和后台任务交给默认值。
持久化确认要看 fsync 模式
MiteDB 把 fsync_mode 分成 OFF、SYNC 和 FULL。OFF 适合可以丢失最近一小段数据的高性能路径;SYNC 与 FULL 把“调用返回”和“数据已经经过更严格持久化屏障”联系起来。Group Commit 可以把一批提交合并到一次 fsync,降低每条记录都触发同步的成本,但它不会改变不同模式的可靠性边界。
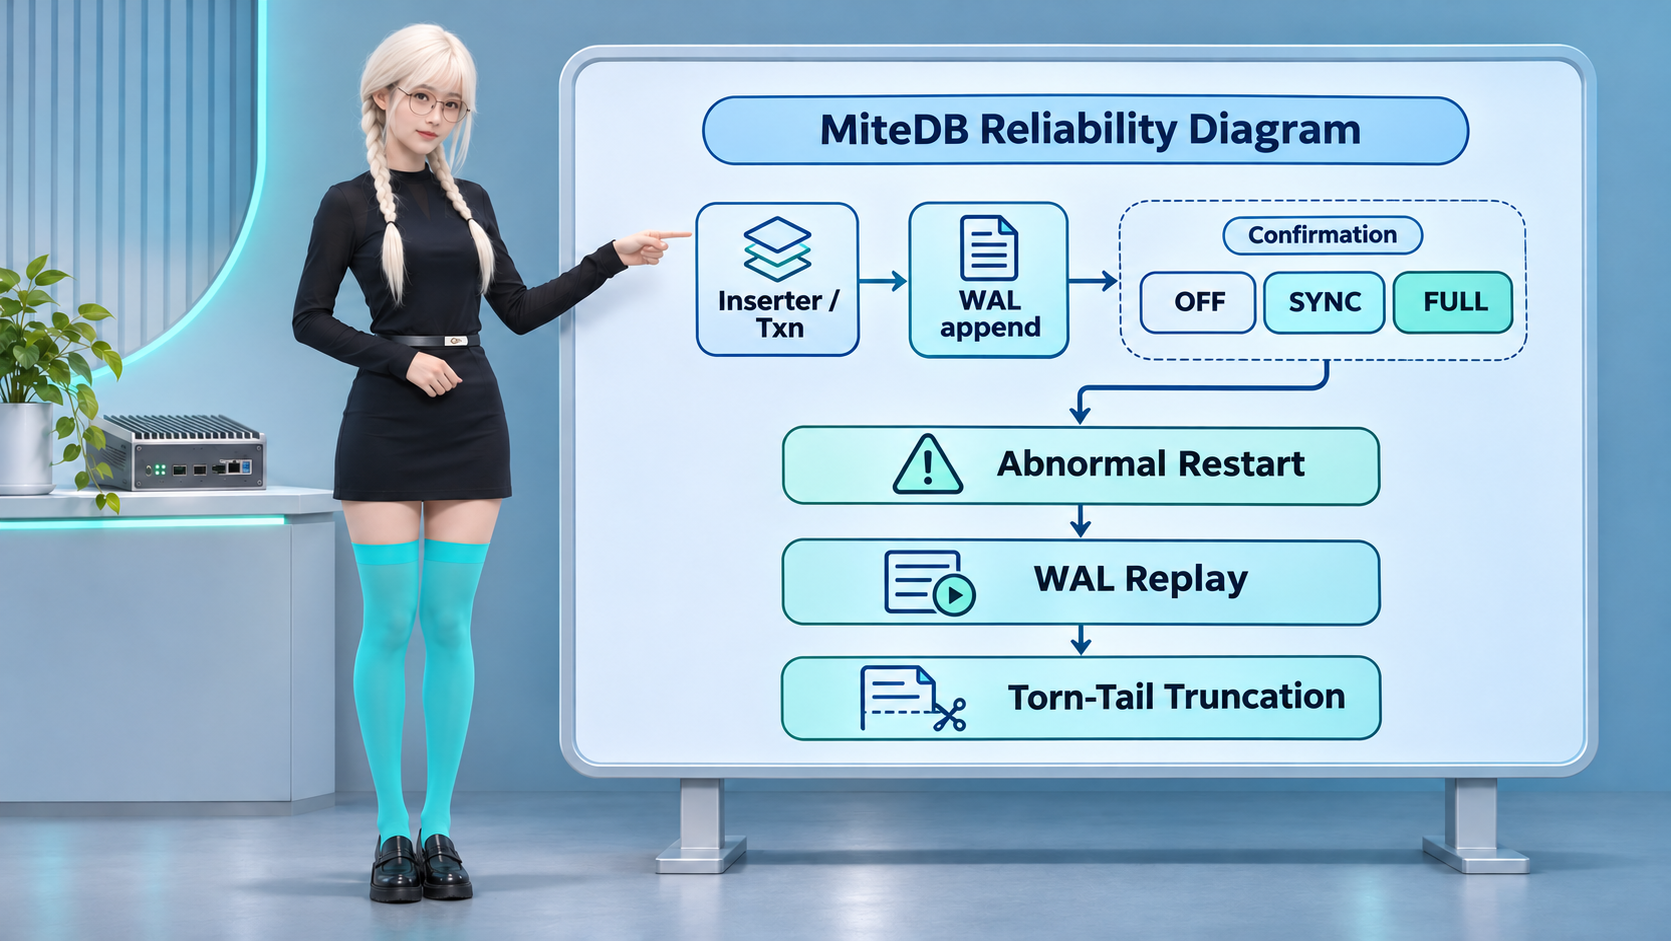
图2:同一位当前批准代言人配合 OFF、SYNC、FULL 与 WAL 重放恢复流程示意。
README 还记录了 WAL 重放、撕裂尾部截断和 LD_PRELOAD 故障注入。我们在本次复核中确实构建并运行了仓库测试,其中包含 test_powerloss、test_txn_crash、test_sync 等用例;但这只证明该提交在当前 x86_64 Linux 环境下的测试结果,不能替代目标板卡上的掉电测试、文件系统测试和长期运行观察。
从源码构建一个最小示例
仓库提供 CMake 和无 CMake 的 GCC 路径。常规 Linux 构建可以从以下命令开始:
cmake -S . -B build -DCMAKE_BUILD_TYPE=Release
cmake --build build -j$(nproc)
ctest --test-dir build --output-on-failure
最小 C 程序只需要打开数据库、建表、写入、同步和查询。下面的片段省略了错误处理,真正接入时应检查每个返回值,并用 mite_errmsg() 取得线程局部错误信息:
#include <mite.h>

int main(void) {
    mite_t *db = mite_open("/tmp/db1", NULL); /* 实际目录为 /tmp/db1.mite */
    mite_sql(db, "CREATE TABLE sensor (v INT64)", NULL, NULL);

    mite_inserter_t *it = mite_inserter(db, "sensor");
    mite_inserter_add(it, 1000, (mite_value_t[]){ mite_v_i64(42) });
    mite_inserter_commit(it);
    mite_inserter_free(it);

    mite_sync(db);       /* flush + fsync */
    mite_close(db);
    return 0;
}
mite_open("/tmp/db1", NULL) 默认会补全 .mite 后缀,也可以用 MITE_NO_DIR_SUFFIX=1 关闭。对设备应用来说,这个约定有利于脚本区分数据库目录和其他工作目录;对升级工具来说,则应该把目录命名规则当作接口的一部分处理。
本次复核得出的结果
我在 Ubuntu 24.04 x86_64、GCC 13.3 和 CMake 3.28.3 环境中浅克隆该提交,完成 Release 配置、编译和 ctest --output-on-failure。仓库报告的 28 个测试全部通过,包括 SQL、聚合、窗口、并发、同步、归档、压缩、崩溃和故障注入相关用例。编译器同时报告了若干警告,因此“测试通过”不等于“没有警告”,更不等于目标设备已经完成发布验收。
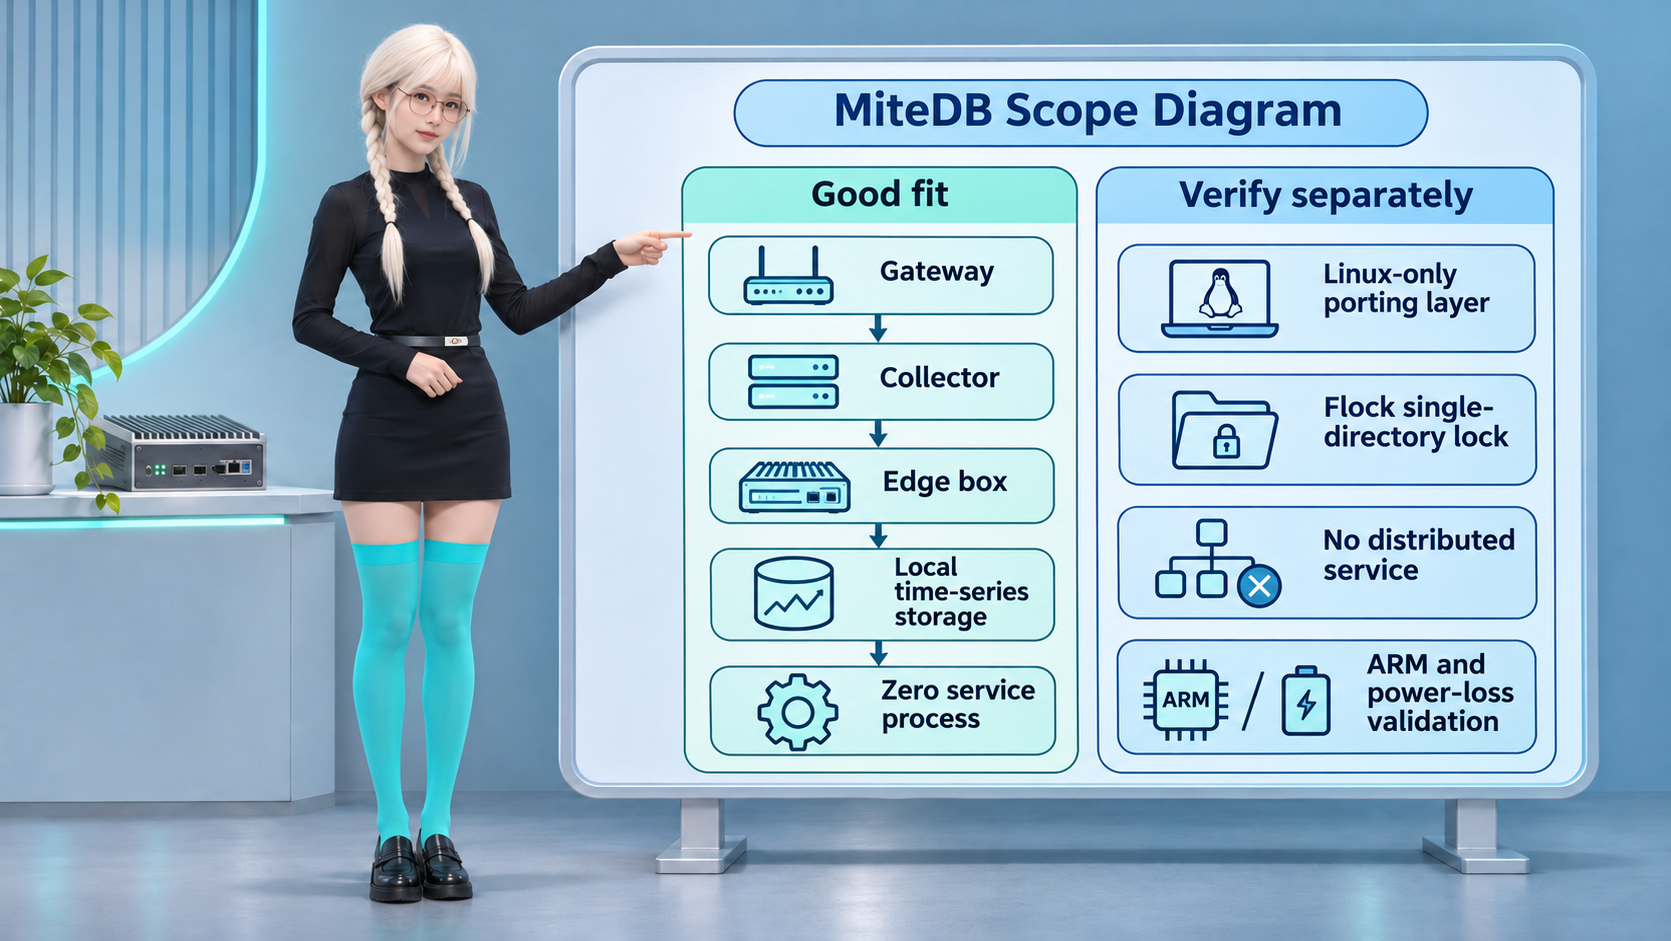
图3:同一位当前批准代言人配合 MiteDB 适用场景和 Linux、单目录、现场验证边界示意。
这次核对没有把 README 中 RK3506/armv7l 的实测数字重新当作我们的实测,也没有虚构吞吐量、生产客户或正式发行包。Gitee 页面在读取时显示该仓库为公开仓库、MIT 许可证、默认分支 master,尚无 Release 和 tag;这些状态会随仓库变化。
适用边界与接入建议
如果你的设备需要一个进程内、低依赖、可控内存的本地时序存储,MiteDB 值得放进技术选型清单。接入前建议按以下顺序验证:
- 先在目标 Linux 内核、文件系统和存储介质上跑完整测试,再单独做掉电和磁盘满测试。
- 根据“最近数据能否丢失”选择 OFF、SYNC 或 FULL,并把选择写进设备配置和运维手册。
- 复核单写者多读者模型;
mite_inserter_t和游标是线程私有的,回调里不能再次调用库 API。 - 如果需要多进程访问同一目录、跨设备复制或云端查询,把互斥、同步和上传协议放在应用层设计,不要把它们假设成 MiteDB 自带能力。
- macOS 和 Windows 当前不在仓库移植层范围内,跨平台产品需要先补
src/os_linux.c对应的抽象实现。
结语
MiteDB 的价值在于把嵌入式时序数据库收缩成一个可以随应用交付的 C 库:没有服务进程和端口,写入与查询路径对设备资源有明确配置点,WAL 和恢复流程也被写进了源码与测试。它的边界同样清楚:当前以 Linux 单机本地存储为中心,目标板卡、文件系统和长期运行仍需要项目自己的验证。
项目源码:https://gitee.com/liukeying011/mitedb
本文原文:https://iotpaper.net/articles/mitedb/mitedb-embedded-timeseries/