
SonnetDB 最近增加的 BM25 相关工作,不是简单地把一个打分函数塞进查询入口。11 月 17 日到 18 日的连续会话,先把“词项出现了多少次、这个词有多稀有、文档有多长”落实成可读的 C# 评分器,再一路推进到 Top-K 堆、Block-Max WAND、磁盘 posting block、惰性读取和有界缓存。每一步都保留了回退路径和可对拍的参照实现。
本文按这条真实提交链解释实现。源码当前位于 main@e2f3ce15bbdbf7367beafb54d1263e00b248f09b;文中的代码、测试和基准都对应这个提交或它的直接祖先。它们属于当前主分支的工程进展,不能写成已经包含在 v5.1.1 正式发行物中的功能,也不能把本机基准扩大为生产性能。
先回答:BM25 在这里解决什么问题
全文搜索最容易被误解成“包含关键词就返回”。真正的查询要回答两个问题:一个词在某篇文档里出现多次,是否更相关;一个词在整个语料里到处都是,是否应该降低权重。还要处理文档长度:一篇很长的说明书天然会包含更多词,不能只靠出现次数把它排在短而精准的文档前面。
SonnetDB 的 Bm25 评分器使用平滑后的 Robertson–Sparck Jones 逆文档频率:
idf(t) = ln(1 + (N - df(t) + 0.5) / (df(t) + 0.5))
词频和文档长度的归一化写成:
tfNorm = tf / (tf + K1 * (1 - B + B * dl / avgdl))
score(t, d) = idf(t) * tfNorm
默认参数是 K1 = 1.2、B = 0.75。N 是参与统计的文档数,df(t) 是包含词项 t 的文档数,dl 是当前文档在字段中的词数,avgdl 是同一字段的平均长度。字段权重由 Bm25FOptions 叠加;未配置字段权重时按 1 处理,权重必须是有限的非负数。
这套公式的意义很朴素:重复出现会提高分数,但会逐渐饱和;罕见词的区分度更高;长文档需要按平均长度校正。它提供的是可解释的关键词相关性排序,不是语义理解,也不替代向量模型。
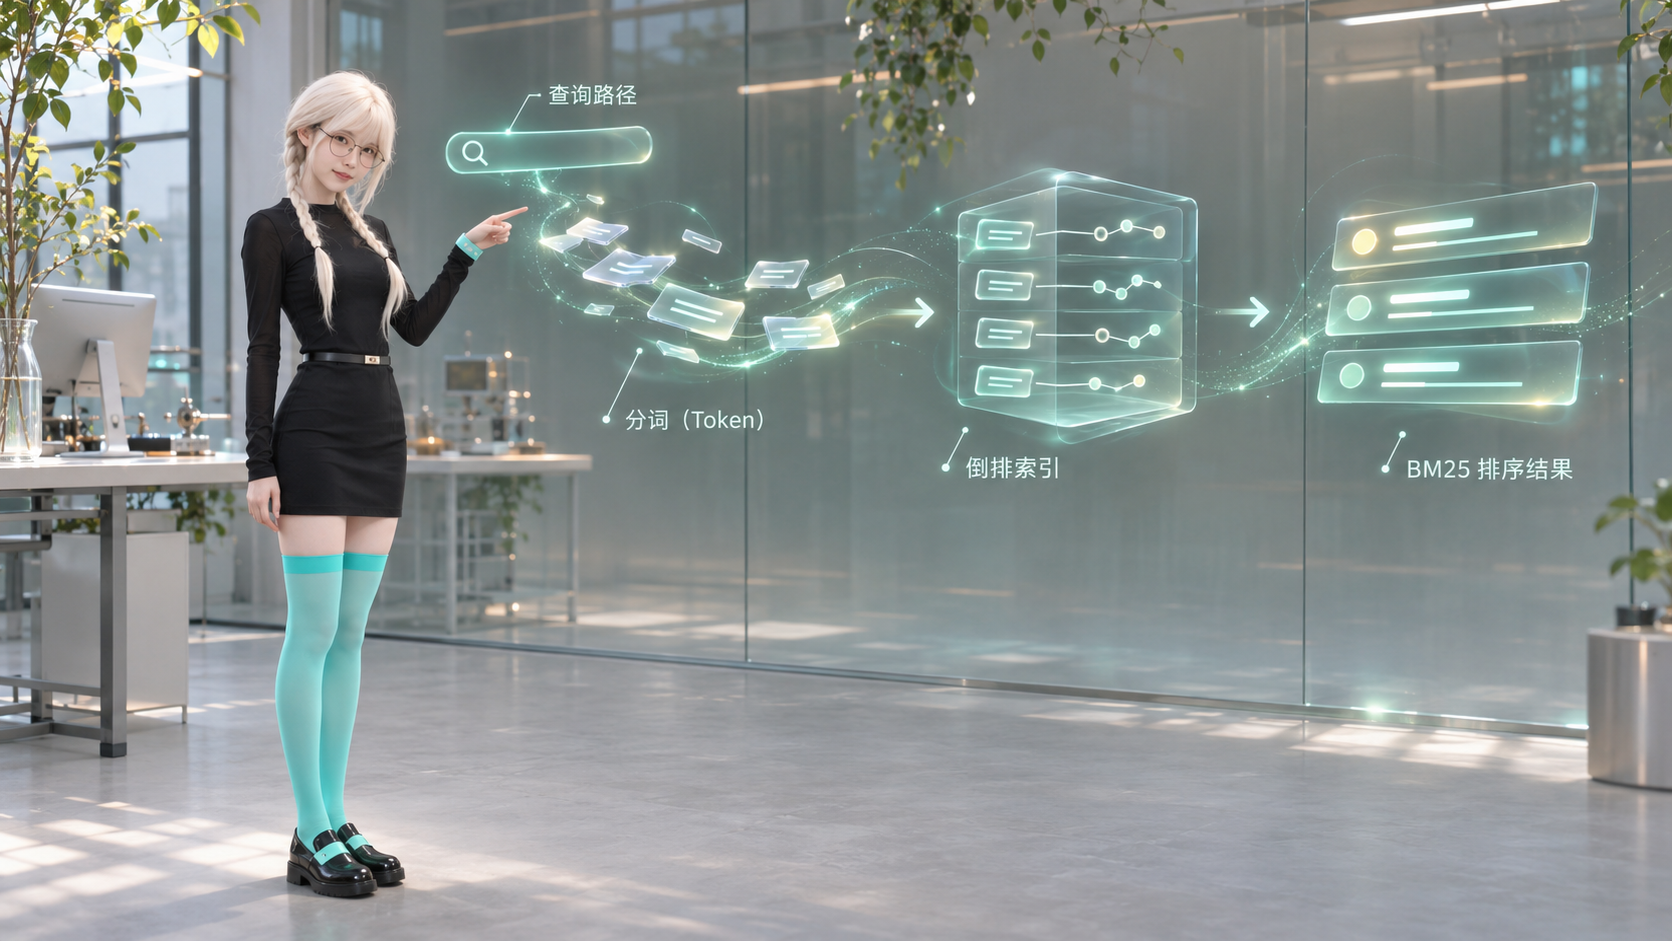
图1:查询、分词、倒排索引和 BM25 排序被放在同一条可见路径中;AI 辅助生成的主题示意图,并非实测截图。
第一段会话:先做一份能对拍的内存实现
InMemoryFullTextIndex 把倒排结构拆成了三层:field + term 找到 posting list,posting list 再按 document ID 找到词频和位置,字段统计则单独保存文档长度。位置数据供短语、邻近和高亮相关路径使用;BM25 本身主要依赖词频、文档频率和字段长度。
查询开始时先把输入解析成 Term、Phrase、Near、And 或 Or 等形状。评分器为候选文档累积分数,最后只把仍然 live 的文档送进 TopKSearchHitHeap。删除产生的 tombstone 不会被当成普通的“分数为零”,而是在候选筛选阶段排除,这一点后面做持久化过滤时非常关键。
这份内存索引的价值不在于永远走它,而在于它是一个清楚的 oracle:持久化索引重开、过滤、WAND 或缓存发生变化时,可以拿同一批文档和同一组查询逐项比较 document ID 与 BM25 分数。后续随机多 segment 对拍正是沿用了这条思路。
第二段会话:Top-K 堆和受限 Block-Max WAND
最初的实现会把所有命中先放入列表,再完整排序。当候选远多于 topK 时,这会同时占用更多内存和排序时间。TopKSearchHitHeap 改为只保留当前最有希望进入结果集的 K 条命中,最终再按“分数降序、document ID 升序”稳定输出。这样既保持分页和回读的顺序合同,也避免按用户给出的超大 topK 预分配一整块数组。
接着加入了受限的 Block-Max WAND。它不是对所有查询形状强行加速,而是只在以下条件同时满足时启用:
- 查询是同一字段上的纯 term
OR; - 新 segment 能提供 DSSEG004 posting block 目录;
- 没有 tombstone,BM25 参数满足安全上界证明;
- 字段统计、live 文档数和每个词项的 posting count 都可核对。
每个 block 先保存一个“这个 block 最多能贡献多少分”的上界。WAND 扫描时,如果这个上界加上当前候选的已知分数仍不可能超过 Top-K 堆的最小分数,就可以跳过 block,连 payload 都不用读。复杂布尔组合、字段混合、短语、邻近、模糊查询、旧 segment 或存在墓碑时,入口会回到原来的 WAND 或完整评分器。
这里的“回退”是设计的一部分。找不到目录、目录不能证明上界或 block 读取失败时,代码不会返回一个看起来正常的空结果,而是放弃这条优化路径,继续走完整评分;这样性能收益会消失,但不会因为优化判断错误而漏召回。
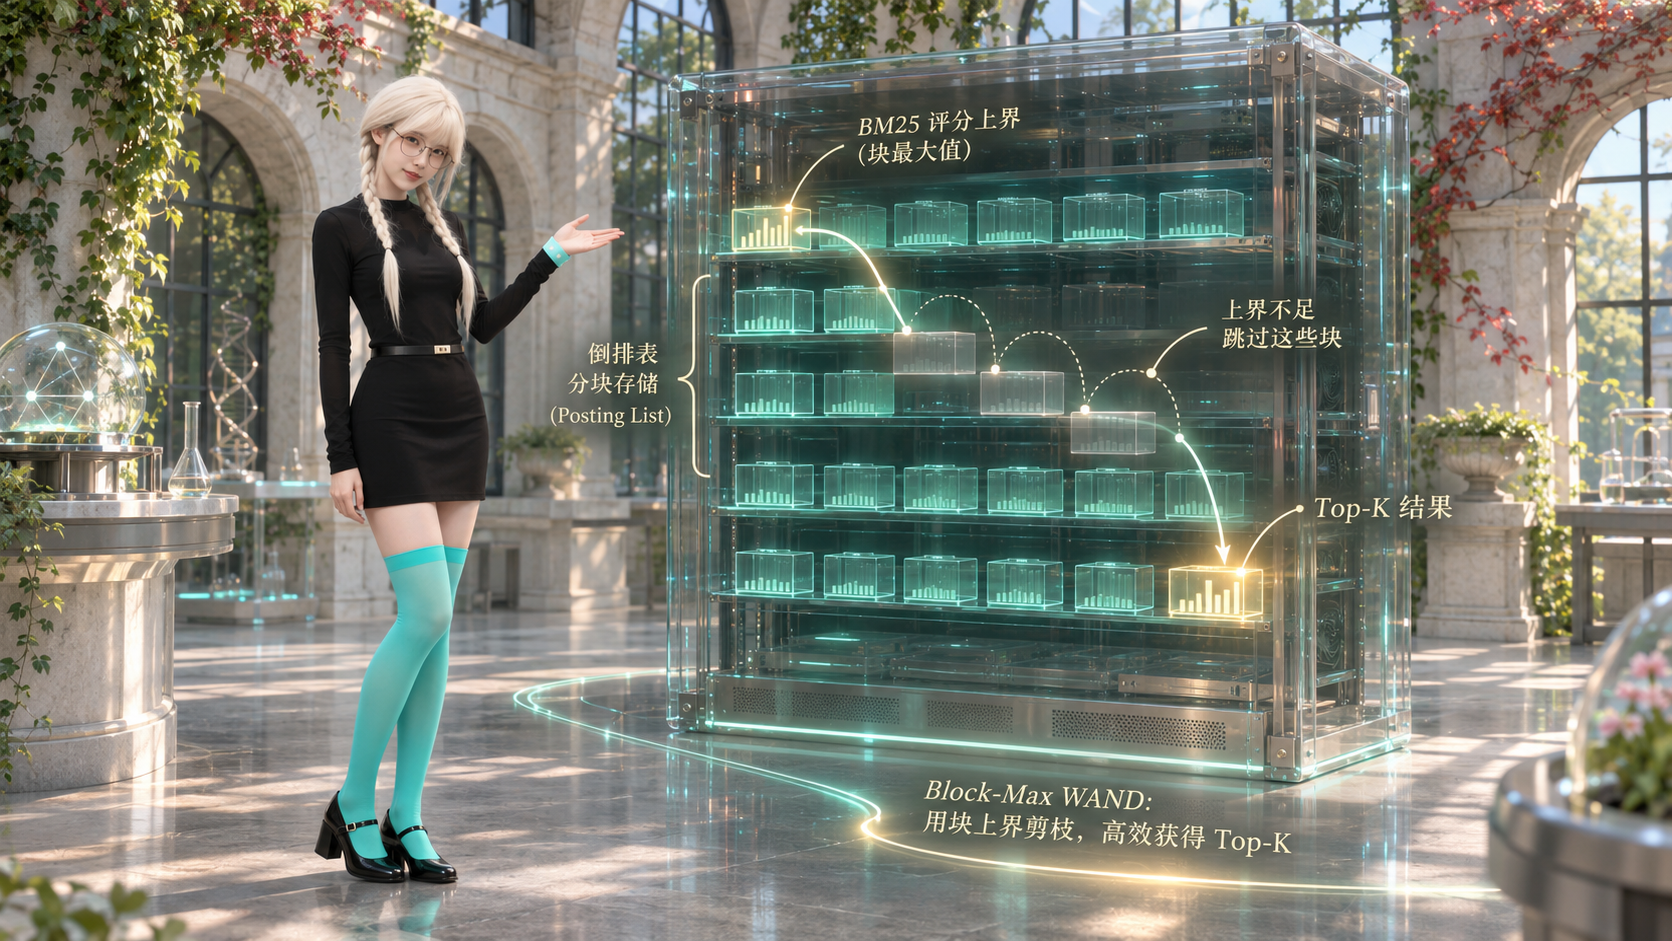
图2:posting block、BM25 上界和 Block-Max WAND 的跳过路径融入透明存储架构;AI 辅助生成的主题示意图,并非实测截图。
第三段会话:把 posting 从整段数据拆成 DSSEG004
为了让上界真正对应磁盘数据,新写入的 segment 使用 DSSEG004 格式。一个词项的 posting 按 128 条记录拆成 block,每个 block 的目录包含:
- payload 在 segment 文件中的偏移和长度;
- 首尾 local document ID;
- posting 数量;
- 该 block 的词频上界;
- payload 的 CRC32。
读取器仍能识别 DSSEG001、DSSEG002 和 DSSEG003。未知 magic、长度越界、目录不一致和 CRC 错误都会 fail closed。新格式并不要求打开索引时把所有 posting payload 解码进内存:PersistentFullTextIndex 先读 manifest 和目录,真正扫描到词项时再按 block seek。
这带来两个直接影响。第一,冷查询的物理读取范围更接近“可能进入 Top-K 的 block”,而不是整个词项的所有 posting。第二,读取器拥有明确的校验边界:目录说有多少条 posting、文档 ID 是否递增、payload 是否完整,都可以在进入评分前检查。
反方审查:上界不能低估,零分命中也不能丢
实现并没有在第一次 WAND 合并后就结束。反向审查发现了几个容易被“性能优化”掩盖的正确性问题。
首先,DSSEG004 目录里的 MaxTermFrequency 不在 payload CRC 覆盖范围内。如果直接相信一个被篡改的较小值,上界可能被低估,算法就会错误跳过本应进入 Top-K 的 block。修正后的做法是使用 BM25 词频趋于无穷时的数学 supremum 作为保守上界;真正载入 payload 后,再核对实际词频不超过目录值。上界可能因此变松,但不会漏召回。
其次,BM25F 权重为零时,合法命中可能得到零分。零分不等于“不存在”,所以 WAND 不能把它们一律删掉。非法 BM25 参数、无法证明上界的目录和 block cursor 创建失败也都回退完整评分;极大的 topK 只从小容量开始增长,避免一次申请过大的结果数组。
随后几次会话把这些边界写成了回归:
- 多 segment、tombstone、stale ID、unknown ID 和空 allowed 集合的确定性随机对拍:
133/133 PASS; - 8 路并发 reopen/search 与同 key single-flight:
135/135 PASS; - 失败 loader 重试、
Clear()竞态和旧 loader 不回填:37/37 PASS。
这些数字是对应定向套件的通过数,不是百万文档容量或生产并发门禁。
第四段会话:4 MiB LRU 和 single-flight
FullTextBlockCache 是按字节预算的 LRU,而不是按条目数量限制。默认测试使用 4 MiB 预算;单个过大的 block、预算为零或缓存禁用时都走可观测的未缓存路径。缓存统计会累计物理 block 读取、读取字节、命中、未命中、淘汰和当前占用,方便把“热读变快”与“确实少读了文件”分开核对。
并发 miss 还有一个很实际的问题:8 个请求同时发现同一个 block 不在缓存里,不能各自打开文件读取。现在同一个 FullTextBlockCacheKey 通过 ConcurrentDictionary 和 Lazy<byte[]> 共享一个 loader,等待者复用同一份已校验字节。loader 抛异常时,faulted 的 inflight 项会被移除,后续请求可以重试。
Clear() 又多了一层代际号。清空时旧条目和 inflight 表都会被清掉并递增 generation。已经在等待的旧 loader 可以把结果交还给原调用方,但不能在清空后重新写回缓存;清空之后的新读取建立新的 single-flight。这个细节避免了“清空成功,旧请求稍后又把旧 block 填回来”的竞态。
一次小语料基线:冷读和热读到底差在哪里
11 月 17 日的独立基准固定生成 1,024 篇文档:偶数文档包含 alpha beta,奇数文档只包含 alpha;查询是同一字段的 OR(alpha,beta),topK=20。冷读每次打开新的 PersistentFullTextIndex,热读复用已经查询过的实例和 block cache。
| 路径 | 迭代 | 均值 | 标准差 | 分配 |
|---|---|---|---|---|
| PersistentFullTextIndex cold block read | 3 | 1,949.1 µs | 158.71 µs | 1,165.11 KB |
| PersistentFullTextIndex hot block read | 3 | 333.0 µs | 9.06 µs | 198.56 KB |
独立统计探针给出了同一轮的物理读取对账:冷读新增 12 个 block、6,154 bytes 和 12 次 cache miss;紧接着的热读新增物理读取为 0,得到 12 次 cache hit,缓存仍占用 12 个 block、6,154 bytes。冷读约是热读的 5.85 倍,只能作为这台 Windows 11、Intel Core Ultra 9 185H、本机 .NET 10 runtime、小语料和 3 次迭代下的相对基线。
标准 BenchmarkDotNet harness 在内部 120 秒构建限制内没有完成,记为 BLOCKED,没有样本被当成结果。基准使用了隔离工程和 InProcess toolchain 才得到上表数据;仓库要求的 SDK 10.0.100 在该机器上缺失,临时使用的 11.0.100 也不改变这个环境边界。
图3:源码、对拍与冷读/热读基线在同一工作空间里串联;AI 辅助生成的主题示意图,并非实测截图。
对普通使用者意味着什么
从代码行为看,这次改动有四个可感知的方向:
- 结果更容易解释。 BM25 仍然是词频、稀有度和长度归一化的组合;复杂查询的回退让排序语义保持一致。
- 大候选集的内存压力更可控。 Top-K 堆不会为所有命中保留完整列表。
- 持久化索引可以渐进读取。 新 segment 的 posting 目录允许按 block 读取,缓存再把同一实例的重复查询变成命中。
- 优化失败时优先保正确性。 旧格式、墓碑、非法参数、坏目录和无法证明的上界都会回退或明确失败,而不是静默返回部分结果。
这并不意味着 BM25 要取代向量搜索。精确的型号、错误码、字段名和 API 名称适合倒排/BM25;同义表达、跨语言改写和语义相近内容仍需要向量/HNSW 或混合召回。两者的关系是按问题组合,而不是把一条路径宣传成所有场景的答案。
当前仍然没有证明的事情
本文刻意把状态分开写:源码定向回归为 PASS,本机小语料基准为 PASS,标准 harness 和 SDK 10 默认路径为 BLOCKED,容量矩阵、长时间 soak、百万文档、跨进程共享缓存、NativeAOT、固定硬件、生产部署、现场设备和公开发行物消费验证仍是 NOT_RUN 或 UNKNOWN。下一阶段设计已经列出 1,024/10,000/100,000 文档、64 KiB/1 MiB/4 MiB/64 MiB 缓存、最多 8 个 worker 和有界 5/15/60 分钟运行,但方案本身不等于执行结果。
因此,读者可以把这条提交链理解成“全文检索从正确性实现走向有界 I/O 的一轮工程化收口”,可以据此阅读源码、复现实验和设计自己的数据集;不要把它当成某个固定硬件上的延迟承诺,也不要把当前 main 的实现进展写成 v5.1.1 已发布能力。
源码与证据
本文的四张图都使用当前 SonnetDB AI 形象代言人,并采用“人物站在技术场景中讲解”的构图。当前图像端点没有确认的 gpt-image-2.6 或更新版本,用户已明确允许本篇临时使用 gpt-image-2.5-sunburst;该例外写入配图回执,不代表项目默认模型门禁已经改变。所有图片都标注为“AI 辅助生成的主题示意图,并非实测截图”。